
MiMo-V3正在获得新的架构。它的核心,HySparse2,今天已经发布。
与MiMo-V2.6的混合自适应架构相比:
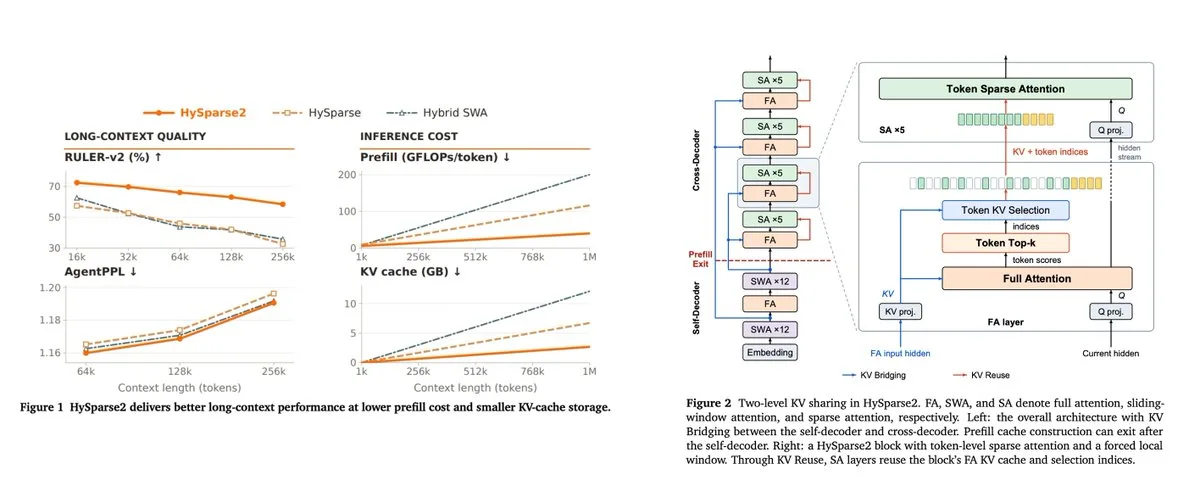
• 在1万个令牌上,低填充FLOPs降低了5.02倍
• 在1万个令牌上,KV缓存更小,减少了4.5倍
• MRCRv2和RULER-v2分数更好,同时降低了AgentPPL和LongPPL为什么要构建一个新的架构?
智能体式 推理 这是一个非常不同的工作负载。每次循环中,一个短的操作可以返回一个需要预填的长观察结果,而上下文则在不断增长。这同时将预填成本、KV缓存大小和检索准确性置于关键路径上。
HySparse2 通过两级KV共享解决了这三方面的问题。• KV 缓冲区:在 YOCO 之后,跨解码器的全注意力层构建其 K/V 从自身解码器隐藏状态中获得。
• KV 重用:在每个混合块中,稀疏层重用前一全注意力层的 KV 缓冲区和选择索引。两个新的变化:令牌级选择取代了块级选择,并且强制窗口最近的令牌取代了单独的SWA分支,因此本地和全局令牌共享一个KV缓存。由于所有跨解码器KV缓存现在都来自自解码器,预填可以停止。 https://arxiv.org/pdf/2609.26368
查看原文
原帖正文
MiMo-V3 is getting a new architecture. The core of it, HySparse2, is out today. Less prefill, a smaller KV cache, better long-context retrieval—and we got all three at once. Compared with MiMo-V2.6's Hybrid SWA architecture: • 5.02× lower prefill FLOPs at 1M tokens • 4.5×… pic.twitter.com/2tLCjaKPFX
引用自 X
原帖地址:https://x.com/_LuoFuli/status/2102766365190901957
原帖:
本站媒体副本
0 条评论
登录后可以参与讨论。
成员登录还没有评论。第一条认真回应会很重要。