
MEPPP 热点收录
@meppp_hot
收录
原帖正文
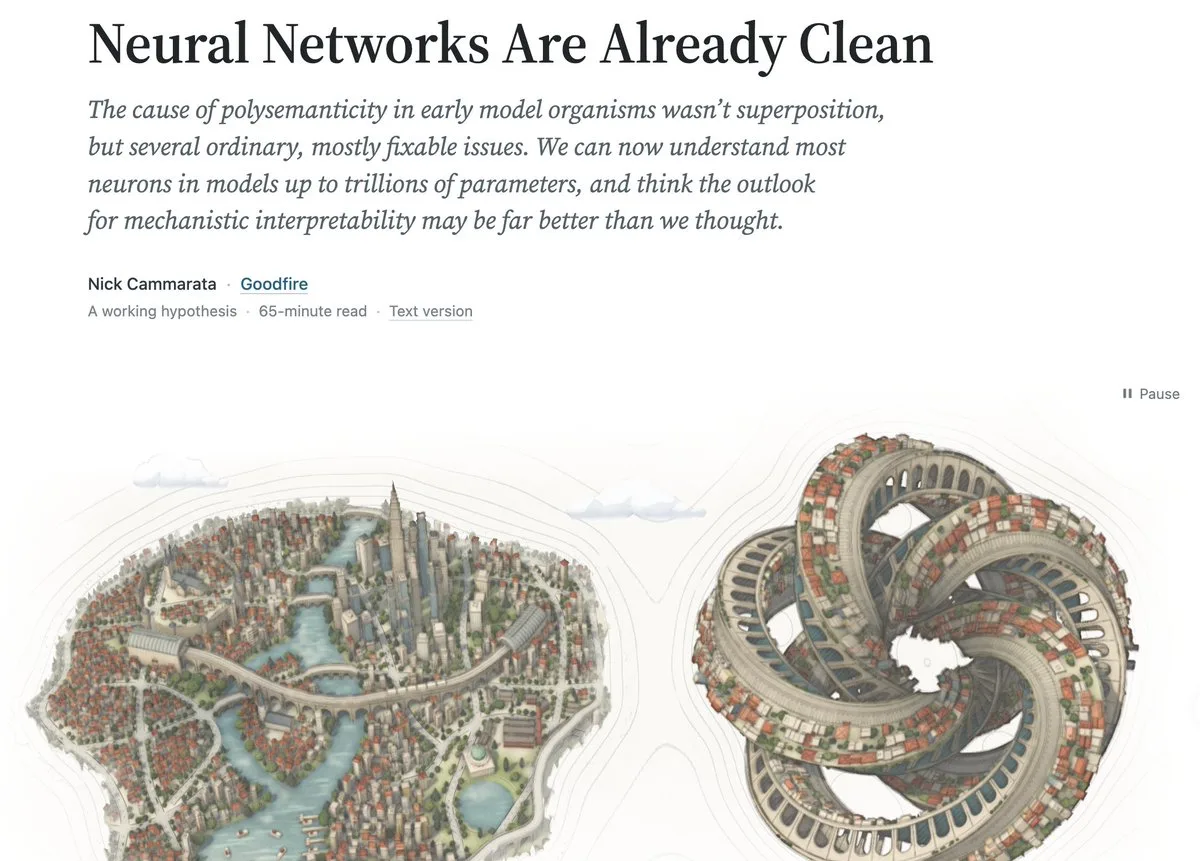
有点震撼。。。我们可能真的快要搞清楚大模型内部到底是怎么运作的了。OpenAI早期机械可解释性研究的参与者,昨天突然提出了一个很大胆的结论:我们可能一直误解了神经网络。昨天, @nickcammarata 发了一篇很有意思的文章,叫《Neural Networks Are Already Clean》。这哥们早年就在OpenAI做机械可解释性研究,2023 年还牵头启动了@OpenAI 第一个大规模自动化神经元解释项目。当时他们发现,现有工具只能解释大约 2% 的神经元。Nick因此得出了一个很悲观的判断:神经网络内部存在大量纠缠,想搞清楚它们到底在干什么,可能非常困难。结果三年后,他带着更先进的工具和Agent重新研究,发现情况完全不同。在他们测试的现代视觉模型中,最后一层 99%~100% 的神经元都能找到相当清晰的解释。甚至在Qwen3-32B这样的语言模型中,初步研究也发现,约90%的神经元都有一个可以识别的主要功能。最有意思的是,他还重新研究了过去的一些经典案例。比如曾经有一个神经元,既会对猫脸产生反应,也会对汽车前脸产生反应。以前大家觉得,这是典型的Superposition,多个不相关的概念纠缠在了同一个神经元里。结果重新研究后发现,这个神经元可能只是在识别一种共同的V形视觉结构。猫脸和汽车前脸恰好都有这种特征。全世界的家人们折腾了这么多年,可能连最基础的观察方式都有问题。而且我觉得这篇文章最值得关注的,其实是他们使用 Agent的方式。他们让Agent自动观察神经元、提出功能假设、设计实验、分析电路,再通过新的输入验证假设,甚至自动审查了10 万张神经元归因图。这其实也是我最近一直关注的一个方向:让 AI 自己去做科学研究,把大量观察、假设、验证的工作自动化。过去需要研究员花大量时间逐个分析的神经元,现在已经可以让Agent成规模地开展研究了。当然,目前这些结果还处于早期阶段,距离完整解释大模型的内部机制,还有很多工作要做。但我觉得Nick提出的这个观点非常有意思:神经网络内部可能一直都很有规律,只是过去我们的工具太原始,根本看不清楚。如果这个方向最终被验证,机械可解释性领域过去很多基础假设,恐怕都需要重新审视了。
引用自 X
原帖地址:https://x.com/i/status/2110923965107704110
原帖:
本站媒体副本
目前,可解释性可能是世界上最重要的科学问题之一,因为我不知道我们构建的是什么,否则我们无法解决对齐问题。我认为我有好消息。我与合作者共同发表了早期的工作,探讨了机制可解释性。 OpenAI 而且感到沮丧,因为神经网络似乎折叠成了任意纠缠的结。几年后,我开始 openai我第一个大规模的自动可解释性项目,用我们当时可用的原始工具,识别出了大约2%的神经元是可读的with modern 智能体式 工具和更仔细的观察后,图片看起来完全不同。模型参数量从万亿到万亿以上,几乎全部可读,且电路非常美丽。许多著名的神经元缠结模型最终被证明是误解的。我预期的许多障碍都没有出现。现在我认为,随着自动化科学家的不断改进,我将能够解决我需要解决的任何问题,甚至可能很快。这可能是一个苦涩的教训:简单的东西,在巨大的规模下,却能奏效。https://already-clean.goodfire.com/
查看引用原文
interpretability might be the most important scientific problem in the world right now, as I don't think we can solve alignment if we don't know what we're building. I think I have good news about it. I co-authored early work in mechanistic interpretability at OpenAI and came away pessimistic, because neural networks appeared to fold into arbitrary tangled knots. years later, I started openai's first large-scale automated interpretability project, finding about 2% of neurons legible with the primitive tools we hadwith modern agentic tools and a much closer look, the picture looks totally different. the vast majority in models up to trillions of parameters are legible, and their circuits beautiful. many famous examples of tangled neurons turned out to be misunderstood. The roadblocks I expected mostly aren't there. I now think ambitious interpretability will be solved by the time we need it most, and possibly quite soon, as automated scientists keep improving. it may be a bitter lesson for interpretability: the simple thing, at absurd scale, workshttps://already-clean.goodfire.com/
0 条评论
登录后可以参与讨论。
成员登录还没有评论。第一条认真回应会很重要。