
MEPPP 热点收录
@meppp_hot
收录
原帖正文
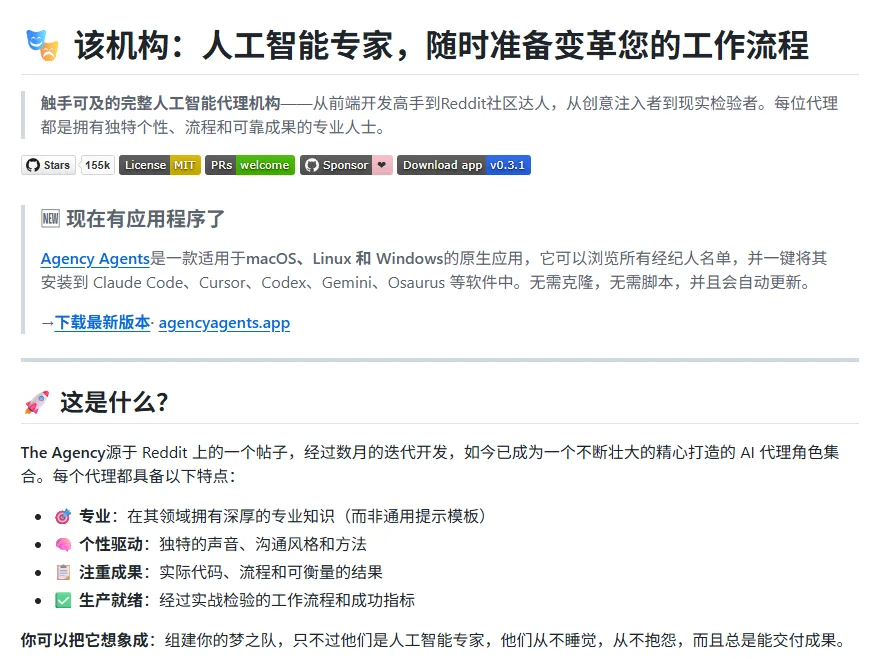
窝趣!兄弟们!这个叫 agency-agents 的 GitHub 项目太牛了!它直接把一家 AI 公司的岗位直接搭好了,拉下来直接用!不是让一个 AI 什么都干,而是拆成 9 个部门、50 多个各管一摊的智能体,让它们像同事一样配合,把一个想法做出来。仓库不到 7 天就涨了 1 万多 Star。
现在已经155万 Star 了。它分的部门大概是这样:
1、工程(7个):前端、后端、移动端、AI、DevOps、原型、资深开发
2、设计(7个):UI/UX、用户研究、架构、品牌、视觉叙事、图像生成
3、营销(8个):增长、内容、Twitter、TikTok、Instagram、Reddit、应用商店
4、产品(3个):迭代优先级、趋势研究、反馈整理
5、项目管理(5个):生产、协调、运营、实验
6、测试(7个):QA、性能分析、API 测试、质量验证
7、支持(6个):客服、数据分析、财务、法务、高管汇报
8、空间计算(6个):XR、VisionOS、WebXR、Metal、Vision Pro
9、专项(6个):多智能体编排、数据分析、销售、分发我觉得最有意思的是它的思路:每个智能体的职责和流程都写清楚,而不是丢给一个万能助手,这样子各司其职,智能体的能力更清晰。这个仓库特别适合想做一人公司、想试试多智能体分工的朋友。有类似想法的一定要看看。Github地址:https://github.com/msitarzewski/agency-agents/
引用自 X
原帖地址:https://x.com/i/status/2104960895172358273
原帖:
本站媒体副本
窝趣!这个开源项目项目也太实用了吧!Crawl4AI如果你平时要抓网页资料、做 AI 知识库、整理行业信息,一定要收藏它!它的作用很简单。把网页链接丢进去,它会把里面的正文抓出来,尽量清成干净的 Markdown。后面无论是喂给大模型、做资料总结,还是放进自己的知识库,都方便很多。以前最烦的就是这一步。网页看着内容很多,复制下来全是导航栏、广告、相关推荐。你再一股脑塞给 AI,不仅效果差,Token 也花得冤。Crawl4AI 就是先把网页内容处理干净,再交给模型。不需要注册它的平台,也没有按次数收费这一套。自己部署后,想抓多少链接就跑多少链接。比如你要做一个行业资料库:先用它批量抓文章
再让 AI 分类、总结、提取观点
最后丢到 Notion、Obsidian 或自己的知识库里
这个流程就能跑起来。
省时又省力。如果你现在正为“抓网页 + 清洗内容”付费,这个项目很值得先拿几个常用网址试一下,能帮你省下一大笔钱了!GitHub地址:https://github.com/unclecode/crawl4ai
再让 AI 分类、总结、提取观点
最后丢到 Notion、Obsidian 或自己的知识库里
这个流程就能跑起来。
省时又省力。如果你现在正为“抓网页 + 清洗内容”付费,这个项目很值得先拿几个常用网址试一下,能帮你省下一大笔钱了!GitHub地址:https://github.com/unclecode/crawl4ai
0 条评论
登录后可以参与讨论。
成员登录还没有评论。第一条认真回应会很重要。