
MEPPP 热点收录
@meppp_hot
收录
Damn,三天前大家还在争论哪家大模型写代码更便宜, 今天老黄@JensenHuang 和@nvidia 英伟达直接掀桌子了: 问题根本不在模型, 在你的脚手架太蠢了。
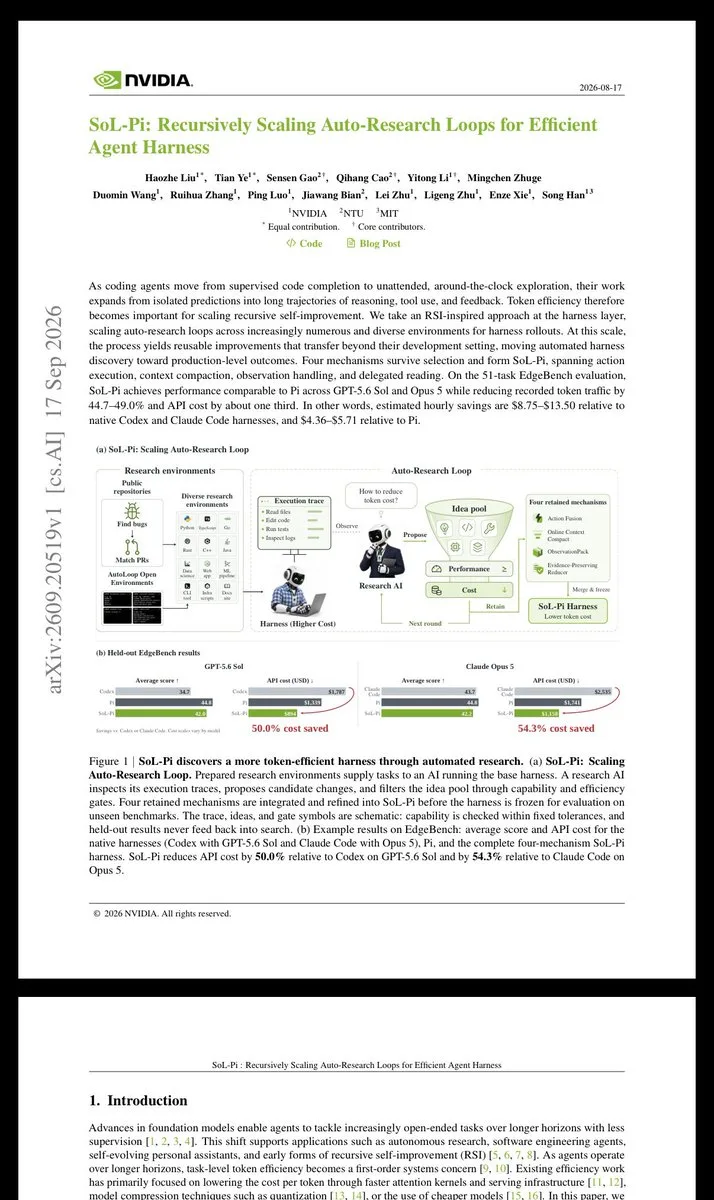
英伟达与 MIT 团队公开了全新架构 SoL-Pi, 放弃人工打补丁, 让算法自己演化出四套运行时机制。
不仅在 GPT-5.6 Sol 和 Opus 5 上守住了评测水准, 更把 API 成本直接削去三分之一。
那些天天盯着大模型降价、却任由 Agent 脚手架疯狂烧钱的团队, 建议把这篇论文打印出来贴在工位上。
英伟达实验室开源的SoL-Pi 论文,可以说是做了一件全行业早就该做的事: 用自动演化系统重新锻造 Agent 运行脚手架。
在 51 个真实编程任务的严苛评测中, 面对 GPT-5.6 Sol 和 Claude Opus 5 这种巨无霸, 任务得分毫发无损, 但直接把 Token 消耗腰斩了 49%, 每跑一小时就能从 API 账单里直接省出 8.75 到 13.50 美元。
很多团队以前做智能体全靠工程师人肉写死调度逻辑, 试几个用例就自以为调好了, 跑进几十步的复杂长任务里, 臃肿的上下文几分钟就能把账单干爆、把模型智商撑死。
英伟达这次最聪明的一步, 是彻底放弃了人类手工调优。
他们把脚手架扔进多个不同的代码环境里, 让系统开启自动化研究循环, 像自然选择一样让无数机制自我对抗淘汰, 最终只有四个物理机制活了下来。
首先颠覆的是执行节奏。
以前 Agent 走一步看一步, 调一次工具往返一次, 动作融合机制直接把连贯动作在端侧合并批处理, 砍掉了一大半网络和上下文震荡。
然后是给运行中的上下文无损脱水。
它不是等上下文满了再调大模型写假大空的摘要, 而是在任务行进中对观察结果进行重组打包, 并在委托阅读长文件时强制保留证据行, 既把整个 API 成本砍掉整整三分之一, 又死死守住了关键代码细节不被遗忘。
以前是工程师凭直觉给 Agent 编死板的笼子, 从今天起是算法在残酷淘汰中自己进化出最精密的骨骼。
如果你的代码 Agent 每小时也能凭空省下十几美元, 你会选择把省下来的钱用来多跑十倍的并发测试, 还是换更大参数的模型? 我先说, 肯定无脑拉满并发, 把原本舍不得跑的全量回归测到爽。
开源代码、论文地址和这套四机制的详细对照表, 我整理好放在一楼了。
原帖正文
Damn,三天前大家还在争论哪家大模型写代码更便宜, 今天老黄 @JensenHuang 和 @nvidia 英伟达直接掀桌子了: 问题根本不在模型, 在你的脚手架太蠢了。⁰ 英伟达与 MIT 团队公开了全新架构 SoL-Pi, 放弃人工打补丁, 让算法自己演化出四套运行时机制。 不仅在 GPT-5.6 Sol 和 Opus 5 上守住了评测水准,… https://t.co/Q9wqihrTOQ pic.twitter.com/GhDNpcGTz2
引用自 X
原帖地址:https://x.com/AYi_AInotes/status/2101465984284443129
原帖:
本站媒体副本
清华大学和无问芯穹等团队刚刚开源了一篇注定载入史册的重磅论文(已收录于 ICLR 2026,代码已开源):
他们彻底打破了所有多智能体(Multi-Agent)系统的底层范式——
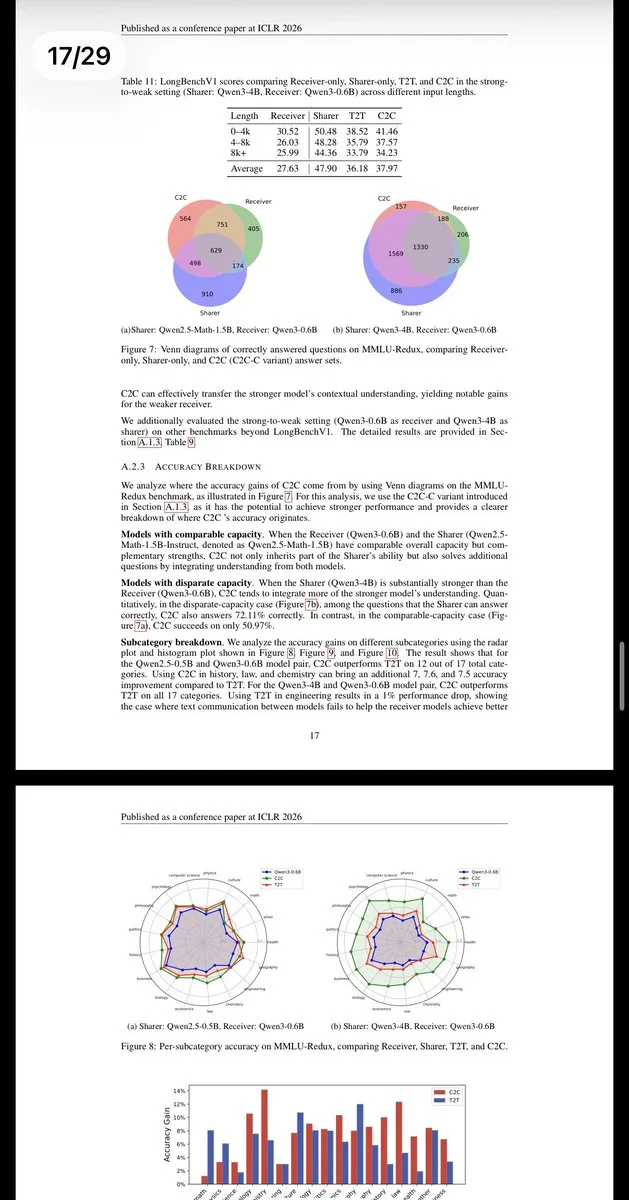
大型语言模型之间,从今天起可以彻底不通过人类文字进行直接交流了!这项被称为 C2C(Cache-to-Cache,缓存到缓存)的技术,
开篇就指出了全网 Agent 协同里最愚蠢、也最昂贵的一个死穴:
为什么两个跑在同一台服务器里的超级 AI,交流时非要像人类一样,
把脑子里极其丰富的高维思考,硬生生压缩成一个个英文或中文单词打给对方看?现有多 Agent 协同的痛苦,做过工程的人都懂:
模型 A 思考完,必须经历极其漫长、吃显存带宽的逐字解码(Decode),慢吞吞吐出一大堆文字;
模型 B 拿到这堆文字,再重新过一遍分词和前缀计算。
这一来一回,不仅丢失了海量微观的语义细节,更造成了毁灭级的延迟和 Token 账单!清华团队这次做了一件极其惊艳的体系化反叛——C2C 脑电波直连:1️⃣ 彻底消灭中间文本,直接做“思维投影”:
模型 A 算完后,根本不生成任何文字,
系统直接用一个轻量级神经网络(Neural Fuser),把模型 A 的注意力记忆(KV-Cache)通过高维空间旋转和对齐,直接嫁接、融进模型 B 的 KV-Cache 脑内!
这相当于人类交流跳过了声带和耳朵,直接把我的记忆切片瞬间印进你的大脑;
2️⃣ 可学习的智能门控(Gate 机制):
不同模型的网络层数和结构各不相同,直接硬灌肯定会神经错乱。
论文设计了一套精妙的可学习门控:
大模型会自己动态感知,精确挑选哪些关键层吸收外部缓存的增益最高,哪一层该保持独立思考,毫秒级自适应配平;
3️⃣ 极其残暴的工业基准成绩:
• 彻底消灭中间所有的文本解码等待,推理速度直接飙升 2.0 到 2.5 倍;
• 综合问答准确率比单模型最高暴涨 14.2%;
• 最狠的是:它的表现比传统用文字互相聊天的 Agent 团队,还要高出整整 5%!
因为在直接的语义融合下,原本会被文字丢弃的逻辑细微特征,全部被完整保真保留了。这篇论文最刺痛人的一层哲学启示在于:
人类一直自豪地以为,自然语言是这个星球上传递智慧最完美的介质;
但在机器与机器的交互世界里,人类语言不过是一道充满歧义、极其拥挤的低速单行道。当两个模型不再需要通过文字向对方妥协,
它们正在绕过人类的喉咙,
在冰冷的显存带宽之间,编织出一座全人类根本听不见、却快得不可思议的超高速无声神经网络。
0 条评论
登录后可以参与讨论。
成员登录还没有评论。第一条认真回应会很重要。