大多数AI视频提示甚至在生成开始之前就失败了。
不是因为模型不好。
因为系统提示您:
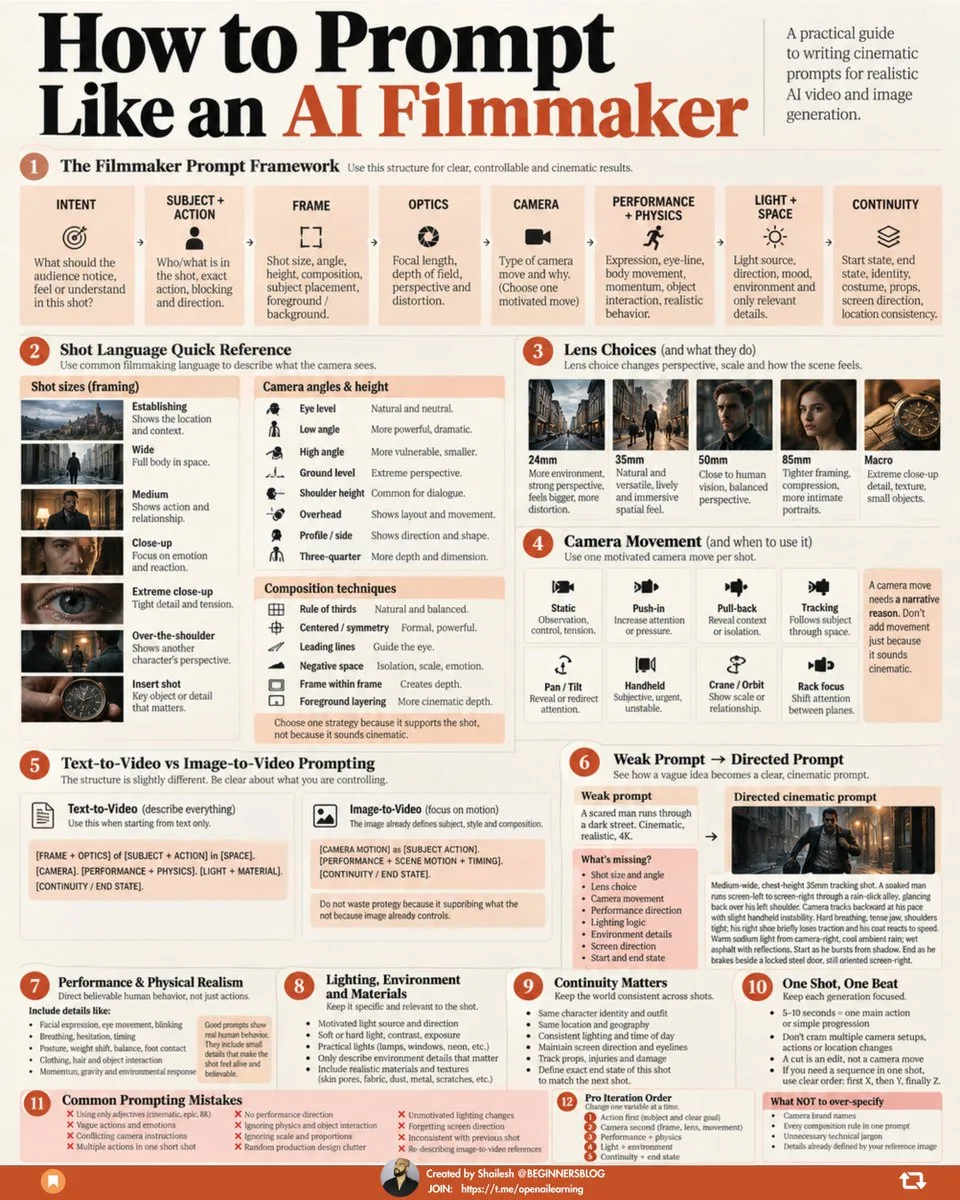
“电影人穿梭于一座城市。逼真。4K。”
这描述了一种氛围。
它不会直接射击。
专业的人工智能电影制作提示应回答:
受众应该注意→什么?
→ 谁在画面中?
他们→ 到底在做什么?
摄像头→ 在哪里?我们使用→什么镜头?
演员表现→如何?
光线从→何而来?
对这个动作→有什么实际反应?
这张照片从→哪里开始和结束?
我使用的框架是:
意图→主题+动作→帧→光学→相机→性能+物理→光+空间→连续性
这实际上意味着什么...
展开全文
不是因为模型不好。
因为系统提示您:
“电影人穿梭于一座城市。逼真。4K。”
这描述了一种氛围。
它不会直接射击。
专业的人工智能电影制作提示应回答:
受众应该注意→什么?
→ 谁在画面中?
他们→ 到底在做什么?
摄像头→ 在哪里?我们使用→什么镜头?
演员表现→如何?
光线从→何而来?
对这个动作→有什么实际反应?
这张照片从→哪里开始和结束?
我使用的框架是:
意图→主题+动作→帧→光学→相机→性能+物理→光+空间→连续性
这实际上意味着什么...
查看原文
原帖正文
Most AI video prompts fail before generation even starts. Not because the model is bad. Because the prompt says: “Cinematic man running through a city. Realistic. 4K.” That describes a vibe. It does not direct a shot. A professional AI filmmaking prompt should answer: →… pic.twitter.com/H0TbgKUeAQ
引用自 X
原帖地址:https://x.com/beginnersblog1/status/2105685837812007258
原帖:
本站媒体副本